2ノードProxmoxを毎週自動パッチする
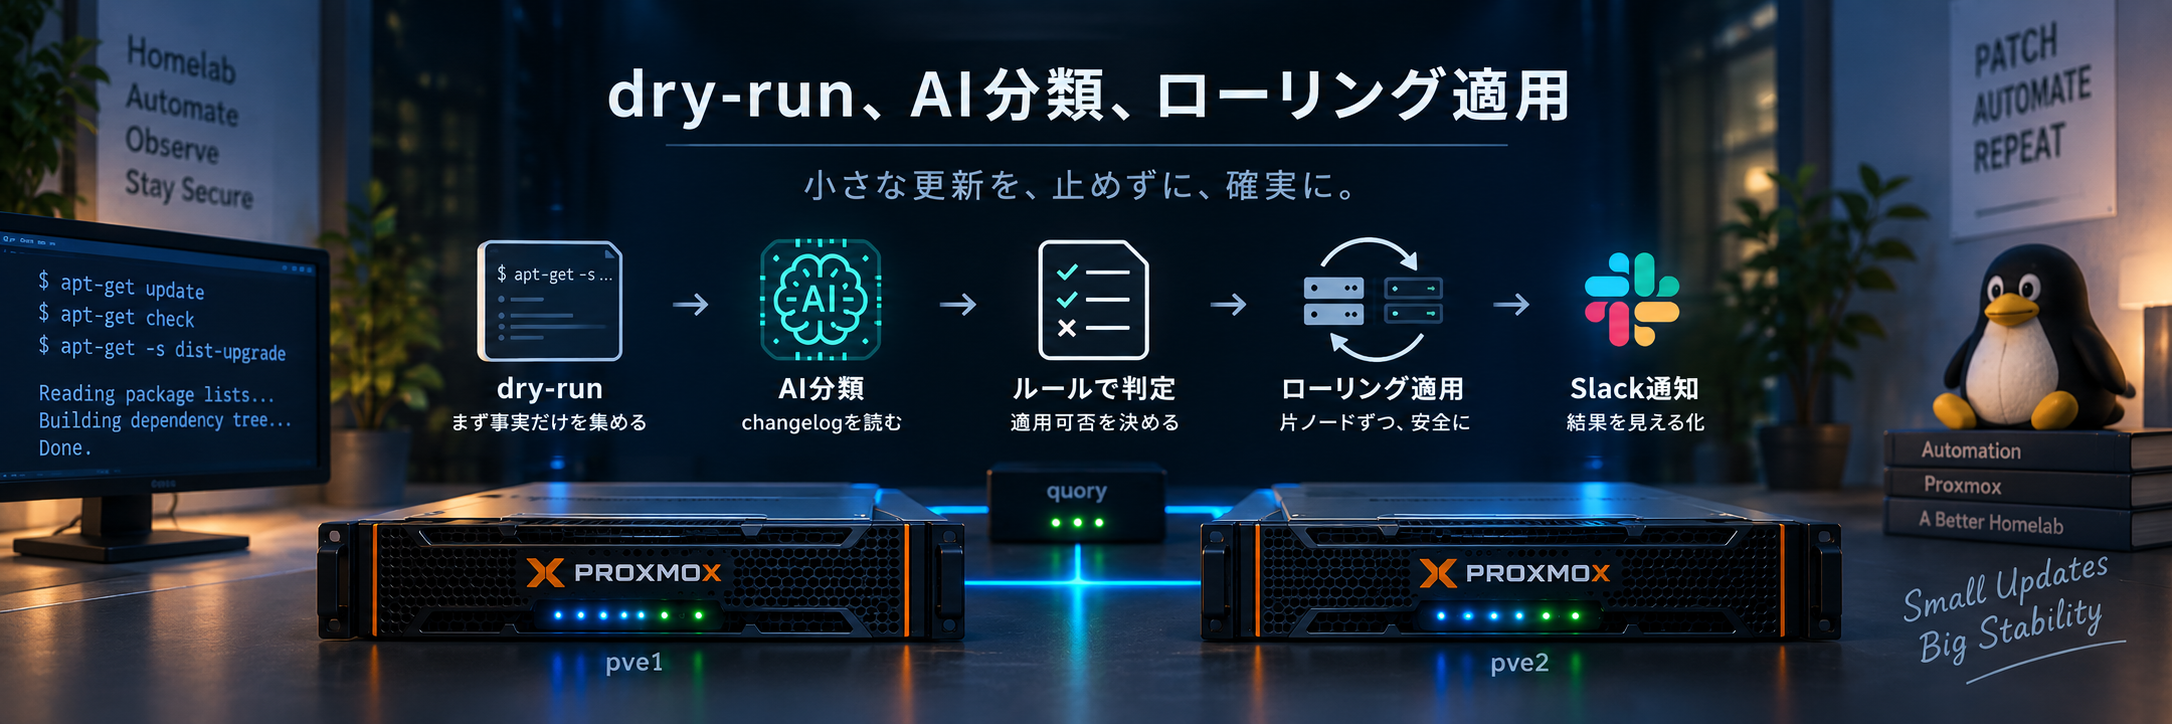
この記事で実現すること
Proxmoxのパッチ適用は、単体ならそこまで難しくありません。GUIで更新を確認して、適用して、必要なら再起動する。それだけです。
ただし、2ノードクラスタで、Firewallや認証サーバをVMとして載せていると話が変わります。
片方ずつ当てたい。
VMは事前に逃がしたい。
quorumは壊したくない。
失敗したら、もう片方には進みたくない。
そして、毎週これを手でやりたくない。
ということで、Proxmoxの週次パッチ適用をAnsibleで自動化しました。
今回の記事は、その仕組みの話です。
単に apt upgrade を自動実行する話ではありません。dry-runで更新候補を集め、重要コンポーネントを判定し、changelogをAIに読ませ、最後はAnsible側のルールで適用可否を決めます。
なぜ自動化したか
毎週、何かしら更新は出ます。カーネル、ZFS、Proxmox本体、マイクロコード。「今週は無い」という週はほとんどありません。
単体サーバであれば、気が向いたときにGUIから更新してもよいと思います。ですが、クラスタでの適用は、単体サーバへの apt upgrade とは別物です。
ゲストをどかす。
片方ずつ当てる。
quorumを壊さない。
片方が戻ってきたことを確認してから、もう片方へ進む。
最後にVM配置を戻す。
手順の数が多く、順番を間違えると面倒なことになります。
さらに私の環境では、Firewallも認証サーバもProxmox上のVMとして動いています。Proxmoxのセキュリティを維持することは、ホームラボ全体の入口を守ることでもあります。
毎週やる作業で、かつ手順が長い。
失敗したときの影響も大きい。
自動化する理由としては、これで十分でした。
構成のおさらいだけ簡単に。pve1 / pve2 の2ノードクラスタに、第3の投票者かつ制御点として、クラスタ外に quory を置いています。詳しくは「自宅のProxmoxクラスタ、AIに運用させる前に何を用意したか」をご覧ください。
週の流れ — 金曜に見て、土曜に当てる
週次パッチは、金曜夕方と土曜早朝の2段構えにしています。
図1 — 2段構え
flowchart LR

FRI["金曜 夕方<br/><b>dry-run</b><br/><small>何が来ているか見るだけ</small>"]
SAT["土曜 早朝<br/><b>full patch</b><br/><small>判定して、当てる</small>"]
SLACK["Slack通知"]

FRI --> SLACK
FRI -.->|"人が見る猶予: 半日"| SAT
SAT --> SLACK

style FRI fill:#1d4ed8,stroke:#60a5fa,color:#fff
style SAT fill:#b45309,stroke:#f59e0b,color:#fff
金曜の夕方にdry-runを回します。ここでは apt-get -s dist-upgrade 相当の処理を行い、実際の変更はしません。結果はSlackへ通知します。大まかなパッチの規模感をここで把握します。
土曜の早朝に本番適用を行います。ここでも、適用直前にもう一度dry-runを走らせます。金曜夕方から土曜早朝までの間に、更新候補が変わる可能性があるためです。
この仕組みは、大きく4段階に分けています。
1つ目は、各Proxmoxノードで更新候補を集めること。
2つ目は、pve1 / pve2の結果を1つのJSONにまとめること。
3つ目は、changelogをAIに読ませて、CVEの種類や日本語レポートを作らせること。
4つ目は、Ansible側で最終判定し、適用してよいものだけを片ノードずつ当てることです。
ポイントは、AIが直接 apt upgrade するわけではない、ということです。AIはchangelogを読む係です。適用するかどうかは、あらかじめ決めたルールとAnsibleの判定で決まります。
dry-runで、まず事実だけを集める
最初にやるのは、判断ではなく収集です。
各Proxmoxノードで、以下を実行します。
1 | # apt-get update |
ここで実行している apt-get -s dist-upgrade はシミュレーションです。実際のパッケージ更新は行いません。
出力された Inst 行を更新候補、Remv 行を削除候補として拾います。さらに、各パッケージに対して apt changelog を取得し、あとでAIが読めるように changelog_diff として持たせています。
イメージとしては、更新候補をこのようなJSONにします。
1 | updates.append({ |
この段階では、まだ「当てる」「止める」は決めません。
Shellの役割は、あくまで事実を集めることです。
判断を混ぜないようにしています。
重要コンポーネントは、先にリスト化しておく
次に、更新候補の中に「重要なもの」が含まれるかを判定します。
ここでいう重要とは、「失敗したときに遠隔から復旧しづらいもの」です。クラスタ、ストレージ、カーネル、マイクロコード、ネットワーク、systemd/udev。ホームラボとはいえ、ここが壊れるとかなり厄介です。
実装では、完全一致と前方一致の2種類で持たせています。
1 | proxmox_patch_dryrun_important_components: |
選定の理由です。
- クラスタの合意形成に関わるもの(
corosync、pve-cluster)は、壊れると2ノードが互いを見失う - ストレージ系(
zfsutils-linux、zfs-zed)は、データに触る - カーネルとマイクロコードは、再起動が必要になり、起動できなくなるリスクもある
- ネットワーク系(
ifupdown2)は、失敗すると遠隔から復旧しづらい systemd/udevは、OSの起動やデバイス認識に関わる
共通しているのは、「失敗したときに、遠隔から直せなくなる可能性があるもの」です。
これが、この環境での重要度の定義です。
判定自体はかなり単純です。
1 | def is_important(name): |
この単純さが大事です。
同じ入力なら、毎回同じ答えが返ります。
なぜ重要と判定されたかも、リストを見れば分かります。
基準を変えたいときは、判定ロジックではなくリストを直します。
毎週の判断を、人間の気分やAIの雰囲気に寄せない。リストに載っているか、prefixに一致するか。それだけです。
通知
パッチの内容についてはSlackで通知しています。上記のロジックを踏まえて最終的には端的な通知文に纏められます。具体的な例で、9/19(土)時点での通知は以下になります。
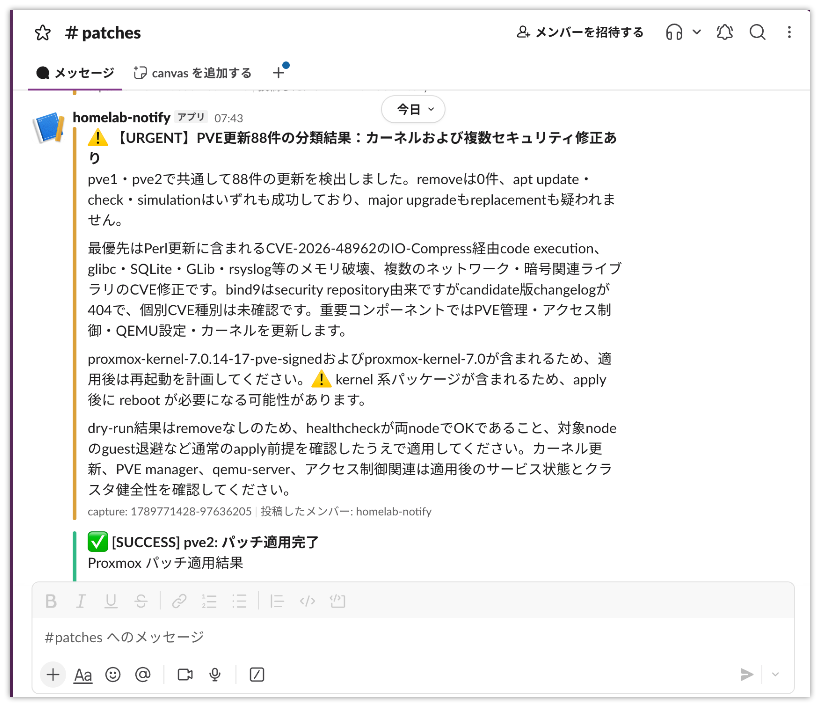
このようにAI(Codex)とPythonとを組み合わせ、端的な通知を得ることで凡その規模感を把握できます。
pve1 / pve2 の結果をまとめる
2ノード構成なので、pve1とpve2で同じ更新が出ることもあれば、片方にだけ出ることもあります。
そこで、ノードごとのdry-run結果をマージします。同じパッケージは1つにまとめ、そのパッケージがどのノードに出ているかを nodes に持たせます。
1 | if name not in merged_by_name: |
これで、次のような見方ができるようになります。
- pve1 / pve2共通の更新
- pve1だけの更新
- pve2だけの更新
- 重要コンポーネントを含む更新
- 削除を伴う更新
ここまで来ると、「なんとなく怖い」ではなく、「何が来ているか」が機械的に見えます。
changelogはAIに読ませる
パッケージ名だけでは、その更新がRCEなのか、LPEなのか、XSSなのかは分かりません。ここはchangelogを読む必要があります。
ただ、毎週すべてのchangelogを人間が読むのはつらいです。
そこでCodex CLIを呼んでいます。
ただし、やらせていることは限定しています。
1 | 各パッケージの changelog_diff を読み、CVEタイプを識別する |
AIが返すのは、あくまで urgency_candidate です。
つまり「緊急度の候補」です。
ここで大事なのは、AIの出力をそのまま信用しないことです。
Codexの出力はJSONとして読めるか、必須キーがあるか、package_classifications の件数が入力の updates 件数と一致するか、ダミーのpackage名を返していないかを検証しています。
1 | if len(classifications) != len(updates): |
AIは便利ですが、出力が壊れることがあります。テンプレートをそのまま返すこともあります。なので、AIの後ろには必ず機械的な検証を置きます。
この仕組みでは、AIは「何が書かれているか」を読む係です。
「当ててよいか」を最終的に決める係ではありません。
緊急度は、changelogから判断する
重要度が「何が更新されるか」だとすると、緊急度は「なぜ更新が来たか」です。
同じパッケージの更新でも、リモートから任意コード実行を踏まれる修正と、管理画面の表示崩れの修正では、扱いが違って当然です。
これも先に一覧にしました。
この種類が出たら緊急扱いにする、というリストです。
1 | RCE / LPE / VM escape / 認証バイパス / exploit公開 / ransomware |
選定の考え方です。
- RCE(リモートコード実行)と認証バイパスは、外から踏める
- LPE(ローカル権限昇格)とVM escapeは、踏まれた後に被害が広がる
- VM escapeは、仮想化基盤では特に重い
- exploit公開 / ransomwareは、実際に悪用されている状況の重さを見る
CVSSのような数値で機械的にリスクを見る方法もあります。ですが、Proxmoxという仮想化基盤を守る前提では、「自分の環境で何がまずいのか」を先に決めておく方が扱いやすいと考えました。
この一覧も、毎週その場で考えるためのものではありません。
判断をブレさせないために、先に決めた基準です。
最終判定はAnsible側で決める
最終的なステータスは、AIではなくAnsible側で決めています。
まず、収集そのものが失敗していれば BLOCKED です。更新候補も削除候補もなければ NO_UPDATES です。この2つはAIを呼ぶ前に決まります。
更新候補がある場合だけ、Codexにchangelog分類を依頼します。
その後、Ansible側で最終ステータスを決めます。
1 | _final_status: >- |
ここで見ているのは、主に次の要素です。
- dry-runが成功したか
- 更新候補があるか
- 重要コンポーネントを含むか
- 削除を伴うか
- メジャーアップグレード疑いがあるか
最終的には、次の5つに落ちます。
| ステータス | 意味 | 自動で当てるか |
|---|---|---|
NO_UPDATES |
更新なし | 当てるものがない |
PATCH_READY |
重要コンポーネントも削除もなし | 当てる |
MAINTENANCE_REQUIRED |
重要コンポーネントあり、または削除あり | 削除がなければ当てる。削除があれば止める |
MAJOR_UPGRADE_DETECTED |
メジャーアップグレード疑い | 止める |
BLOCKED |
dry-runやapt状態の確認に失敗 | エラー表記で止める |
土曜早朝の本番適用でも、適用直前にもう一度dry-runします。金曜の結果だけを信用しないためです。
その再dry-runの結果、削除を伴う MAINTENANCE_REQUIRED や MAJOR_UPGRADE_DETECTED であれば、自動適用は止めます。
1 | _redryrun_requires_confirmation: >- |
これにより、「AIが大丈夫と言ったから当てる」という形にはしていません。
重要なものは重要なものとして扱う。
削除を伴うなら止める。
メジャーアップグレード疑いも止める。
その判断基準はコード側に残します。
BLOCKED だけは、警告ではなくエラー相当の通知にしています。ここを一緒にすると、壊れているときほど「問題なし」に見える通知が届きます。dry-runがエラーで何も返せなかった週も、静かに正常になる。それが一番怖いことです。
図2 — 判定の流れ
flowchart TB

COLLECT["各ノードで収集<br/><small>apt-get -s dist-upgrade</small>"]
OK{"収集は成功したか"}
ANY{"更新はあるか"}
IMP["重要コンポーネント判定<br/><small>完全一致 + 前方一致</small>"]
DEC{"重要 or 削除あり?"}
AI["AIでchangelog分類<br/><small>CVE種別・レポート生成</small>"]
FINAL["Ansibleで最終判定"]

COLLECT --> OK
OK -->|"いいえ"| BLOCKED["BLOCKED<br/><small>エラー表記で止める</small>"]
OK -->|"はい"| ANY
ANY -->|"なし"| NOUP["NO_UPDATES"]
ANY -->|"あり"| IMP
IMP --> AI
AI --> FINAL
FINAL -->|"安全に進められる"| READY["PATCH_READY<br/><small>当てる</small>"]
FINAL -->|"削除・メジャー等"| STOP["停止<br/><small>手動確認</small>"]
FINAL -->|"重要だが削除なし"| MAINT["MAINTENANCE_REQUIRED<br/><small>条件付きで当てる</small>"]

style BLOCKED fill:#991b1b,stroke:#ef4444,color:#fff
style READY fill:#166534,stroke:#22c55e,color:#fff
style STOP fill:#991b1b,stroke:#ef4444,color:#fff
適用 — pve2から始めて、pve1へ進む
本番適用は、pve2から始めます。
pve2を先行検証ノードとして扱い、pve2が正常に戻ってからpve1へ進みます。pve2のpost-healthcheckがNGなら、pve1には触りません。両方壊すのを防ぐための順序制約です。
流れはこうです。
1 | pve2: |
実装上も、proxmox_patch_weekly_full.yml でこの順番にplaybookを呼んでいます。
1 | - import_playbook: proxmox_evacuate_node.yml |
pve2の適用とヘルスチェックが終わってから、pve1側へ進みます。
図3 — 片ノードずつ
flowchart TB

subgraph pve2run["pve2 の番"]
    E2["退避<br/><small>VMをpve1へ移す</small>"] --> P2["パッチ + 再起動"]
    P2 --> H2["ヘルスチェック"]
    H2 --> R2["復帰<br/><small>VMを戻す</small>"]
end

subgraph pve1run["pve1 の番"]
    E1["退避<br/><small>VMをpve2へ移す</small>"] --> P1["パッチ + 再起動"]
    P1 --> H1["ヘルスチェック"]
    H1 --> R1["復帰"]
end

H2 -->|"OKなら次へ"| E1
H2 -.->|"NGなら止める"| STOP["停止・通知<br/><small>pve1には手を付けない</small>"]

style STOP fill:#991b1b,stroke:#ef4444,color:#fff
退避はHA管理VMの移動です。Firewallも認証サーバも、ここで一緒に移ります。
ここは意図的にオフラインマイグレーションにしています。パッチでQEMUのバージョンが変わる可能性がある以上、新旧バージョンのQEMUをまたいでオンラインマイグレーションをするのは避けたいからです。
動いたまま無停止で移すよりも、一度止めて確実に移す方を選びました。移動のたびに数十秒止まるのは、その結果です。
なので、厳密には完全な無停止ではありません。HA管理VMは移動のときに停止→移動→起動になります。
ただし、クラスタ全体を止めてメンテナンスするわけではありません。片方のノードを処理している間、もう片方がVMを受けます。私の環境では、完全なオンラインマイグレーションよりも、短い停止を許容して確実に移す方を選びました。
復帰は「元の配置に戻す」だけです。戻せなくても致命ではありません。どちらのノードでも動くからです。ただ、平常時の配置に戻っていた方が、次の運用が分かりやすくなります。
片側しか生きていないときは、無理に進めない
通常はpve2 → pve1の順に処理します。
ただし、現実の運用では、片方のノードが到達不能だったり、ヘルスチェックでNGになることもあります。その場合、以前のように「両方そろっていないから全部中止」とすると、片側だけ安全に処理できる場面でも止まってしまいます。
一方で、片側しか生きていない状態で、VMを無人で止めてまでパッチを強行するのも危険です。
そのため、現在の実装では、到達不能または不健全なノードは今回の対象から外します。ただし、適用対象が1ノードだけになった場合、そのノードにrunning guestが残っていれば自動適用は見送ります。退避先がないからです。
つまり、考え方はこうです。
- 両方とも健全なら、pve2 → pve1でローリング適用する
- 片方が不健全なら、そのノードは今回の対象から外す
- 片方だけが対象でも、running guestが残っていれば自動適用しない
- 両方とも使えない、または判断できない場合は止める
壊れているときほど、静かに成功扱いにしない。
ここはかなり大事にしています。
実装はGitに置く
この仕組みは、すべてrepoに置いています。
読みどころはこのあたりです。
roles/proxmox_patch_dryrunroles/proxmox_patch_apply_nodeplaybooks/proxmox_patch_weekly_full.ymlscripts/codex-classify.sh
dry-runで何を集めるか。
何を重要コンポーネントとみなすか。
AIに何を読ませるか。
AIの出力をどう検証するか。
どのステータスなら自動適用するか。
どのステータスなら止めるか。
こうした判断を、できるだけGit上に残しています。
もちろん、すべてを完全にコード化できるわけではありません。ですが、「なぜそう動くのか」をあとから読める形にしておくと、運用はかなり楽になります。
運用してみて
一番効いたのは、退避や再起動をAnsible化したことではありません。
何を重要とみなすか。
何なら自動で進めるか。
何なら人間に戻すか。
これを先に決めて、コードにしたことです。
毎週のパッチ適用で一番つらいのは、実はコマンドを打つことではなく、「これは今当てていいのか」と毎回考えることでした。そこを機械に渡せる形まで分解できると、運用はかなり軽くなります。
実装はAIにかなり手伝ってもらっています。私が手でコードを書くことはほとんどありません。
ただし、AIに任せているのは実装や調査、changelogの読み取り、日本語レポートの作成です。人間が決めるのはポリシーです。
どこまで自動で進めるのか。
何が来たら止めるのか。
失敗したとき、どちら側に倒すのか。
通知だけでよいのか、ジョブ自体を失敗させるのか。
こういう基準を先に決めておくと、AIはかなり使いやすくなります。
最初は要求事項を書いていました。実装が増えるほど、個別のお願いよりも、ポリシーとして残す方が効くようになります。結局のところ、自動化で大事なのは「何をしたいか」よりも、「何をしてはいけないか」を明確にすることでした。
AIに任せる範囲を広げるほど、人間の判断が不要になるわけではありません。むしろ、人間が判断すべき場所を狭く、濃くしていく感じです。
このブログでAIについて何度か書いていますが、考え方は同じです。AIを信じるのではなく、雑用を減らし、人間が本当に見るべき判断に集中できるようにする。
Proxmoxの週次パッチも、その一例です。
repoはこちらです。